Liquid AI lanza LFM2.5: modelo MoE eficiente para dispositivos locales
Por Redacción Automatización LatAm · 28 de mayo de 2026 · Fuente original: MarkTechPost
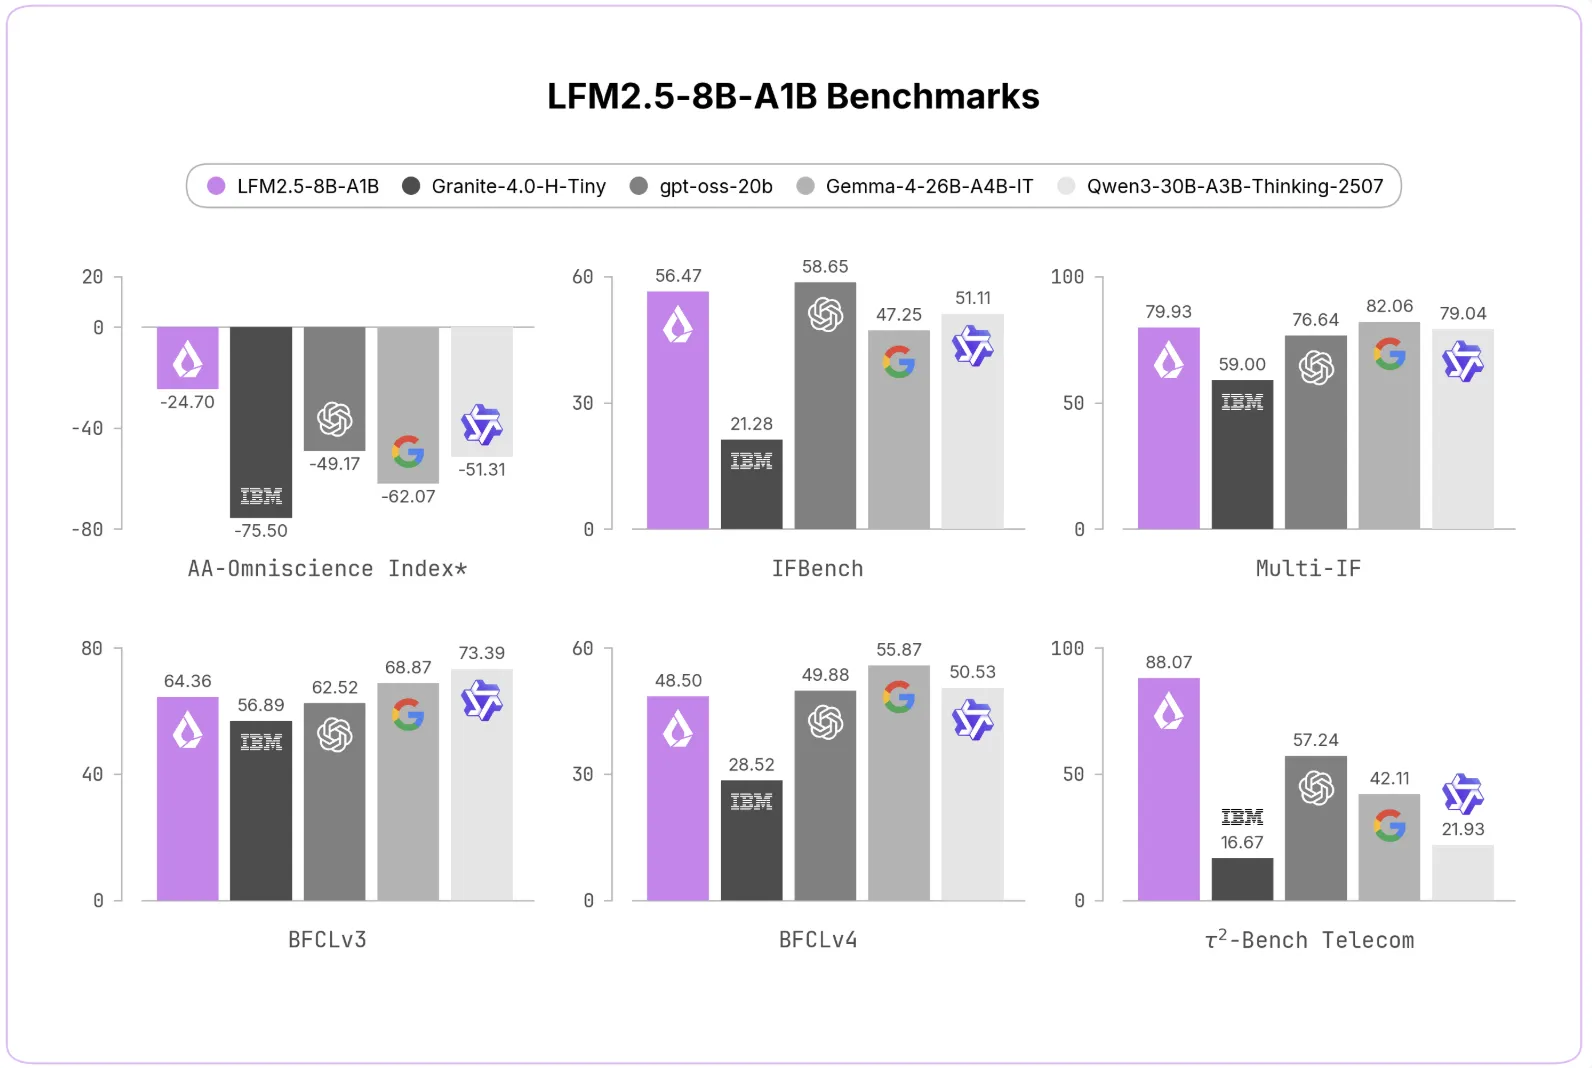
Liquid AI presenta un modelo de lenguaje optimizado con arquitectura Mixture of Experts que activa solo 1.5B de 8.3B parámetros totales, permitiendo ejecución en hardware de consumo con ventana de contexto de 128K tokens y capacidades de razonamiento.
Contexto: La necesidad de eficiencia en modelos grandes
A medida que los modelos de lenguaje generativos se vuelven herramientas industriales, surge un desafío crítico: ejecutarlos en hardware convencional sin comprometer capacidad. Liquid AI, empresa especializada en optimización de redes neuronales, ha abordado este problema con una arquitectura de expertos dinámicos.
El modelo LFM2.5-8B-A1B
Liquid AI lanzó su modelo LFM2.5-8B-A1B con una característica distintiva: aunque contiene 8.3 mil millones de parámetros totales, solo activa 1.5 mil millones durante la inferencia. Esta activación selectiva utiliza una estrategia Mixture of Experts (MoE), donde el modelo enruta cada entrada a solo los módulos especializados necesarios, no a toda la red.
El resultado es un modelo que demanda significativamente menos memoria y potencia computacional que alternativas de tamaño comparable, haciéndolo viable en laptops, servidores edge y dispositivos locales de mediano rendimiento.
Especificaciones técnicas y capacidades
El modelo mantiene una ventana de contexto de 128,000 tokens, comparable a soluciones empresariales. Soporta razonamiento paso a paso, esencial para tareas analíticas en plantas y oficinas, así como tool calling—capacidad de invocar funciones externas, APIs y sistemas de terceros directamente desde las respuestas del modelo.
Esta configuración lo hace particularmente útil para automatización de procesos: puede analizar datos de sensores industriales, generar recomendaciones, e invocar acciones en sistemas de control sin intermediarios.
Implicaciones para LatAm y manufactura
En contextos industriales latinoamericanos, donde la conectividad puede ser intermitente y los costos de infraestructura cloud importan, un modelo MoE eficiente abre nuevas posibilidades. Plantas con recursos limitados pueden integrar capacidades de IA en aplicaciones de optimización de procesos, detección de anomalías y generación de reportes sin depender de APIs remotas.
Además, la arquitectura MoE de Liquid AI es relevante para desarrolladores que necesitan personalizar modelos. Al activar subconjuntos dinámicos de parámetros, el modelo es más adecuado para fine-tuning en dominios específicos—nomenclatura de equipos industriales, procedimientos de seguridad, normativas locales—que alternativas monolíticas.
Disponibilidad y adopción
El lanzamiento de LFM2.5-8B-A1B refuerza la tendencia de democratización de IA generativa. Modelos eficientes como este, ejecutables en hardware local, compiten con soluciones propietarias basadas en API y reducen la barrera de entrada para pequeñas y medianas empresas industriales en la región.
Liquid AI ha posicionado el modelo para uso comunitario, lo que facilita iteración rápida y adaptación a casos de uso específicos del sector manufacturero y de servicios en América Latina.
Este resumen es un análisis original. Para leer la noticia completa visita la fuente original: MarkTechPost →
Sigue leyendo
Writer lanza modelo IA optimizado para reducir costos por token
Writer presenta un nuevo modelo de lenguaje basado en GLM-5.2 de código abierto, diseñado para ofrecer capacidades listas para producción con un costo significativamente menor por procesamiento de datos.
Fuente: TechCrunch AI
Altman y el debate sobre el ritmo de desarrollo de la IA
Sam Altman plantea la necesidad de modular la velocidad de avance en IA generativa. La propuesta cuestiona el modelo de escalado acelerado que ha dominado la industria y abre un debate sobre sostenibilidad técnica y regulatoria.
Fuente: TechCrunch AI
Laguna S 2.1: modelo de IA para código que sorprende en rendimiento
Poolside presentó Laguna S 2.1, un modelo de código de 118B parámetros con arquitectura Mixture-of-Experts que compite con sistemas mucho más grandes en benchmarks de programación agentica. Ejecutable en una sola GPU NVIDIA DGX Spark con licencia abierta.
Fuente: MarkTechPost
Paul Christiano se incorpora a la junta directiva de la Fundación OpenAI
Un experto en alineación y seguridad de IA se suma a la estructura de gobierno de OpenAI para reforzar el comité de seguridad y definir estándares de confiabilidad en sistemas de IA generativa.
Fuente: OpenAI Blog
IA más potente y accesible: nuevas capacidades para la industria
OpenAI presenta avances en modelos de IA que reducen costos y amplían capacidades, permitiendo que empresas e industrias realicen tareas más complejas de forma económicamente viable.
Fuente: OpenAI Blog
IA optimiza tareas que la robótica no puede automatizar
En fábricas de alto desempeño, los operarios aún realizan entre 75 y 80% de las actividades. La IA generativa complementa la automatización robótica en procesos que requieren adaptabilidad, decisión compleja o interacción humana, ampliando el valor sin reemplazar trabajadores.
Fuente: IIoT World